FaceBlur-Genauigkeitstest
Beginnen Sie bei der Prüfung der Gesichtsabdeckung mit Gründlich, dem Standardanalysemodus. In den hier geprüften Bewegungsfällen deckte Gründlich Kopfrollbewegungen und Zeiträume mit 2× Geschwindigkeit ab, die Schnell übersah. Schnell bleibt verfügbar und beide Modi erfordern weiterhin eine vollständige Exportprüfung.
Anleitung aktualisiert am 5. November 2026 · Testläufe:
Der Abschnitt zur aktuellen App enthält Regressionstests mit Stockmaterial, die eine Tracking-Korrektur unterstützten. Das historische Ergebnis von 98,3 % stammt aus einem separaten Testlauf mit fester Stichprobe und bewertet nicht die aktuelle App. Keines ist eine Garantie für Ihren Clip. Für diese Tests und öffentlichen Nachweise wurden keine von Nutzern hochgeladenen Inhalte verwendet.
Aktuelle App: Bewegungs-Regressionstests
Gründlich ist jetzt der Standard für einzelne Videos und Stapel. Schnell bleibt verfügbar. Die Analyse verwendet außerdem zwei übereinstimmende Erkennungen, um den vorherigen Frame eines neu auftauchenden Gesichts innerhalb eines kurzen Zeitfensters und derselben erkannten Szene abzudecken.
Neun frisch heruntergeladene Stockvideos, 12 Szenarien, 63 Sekunden und 1.512 aufeinanderfolgende Frames pro Modus. Drei Szenarien laufen zusätzlich mit doppelter Geschwindigkeit. Es wurden keine Nutzer-Uploads verwendet.
Ergebnisse bei Bewegung
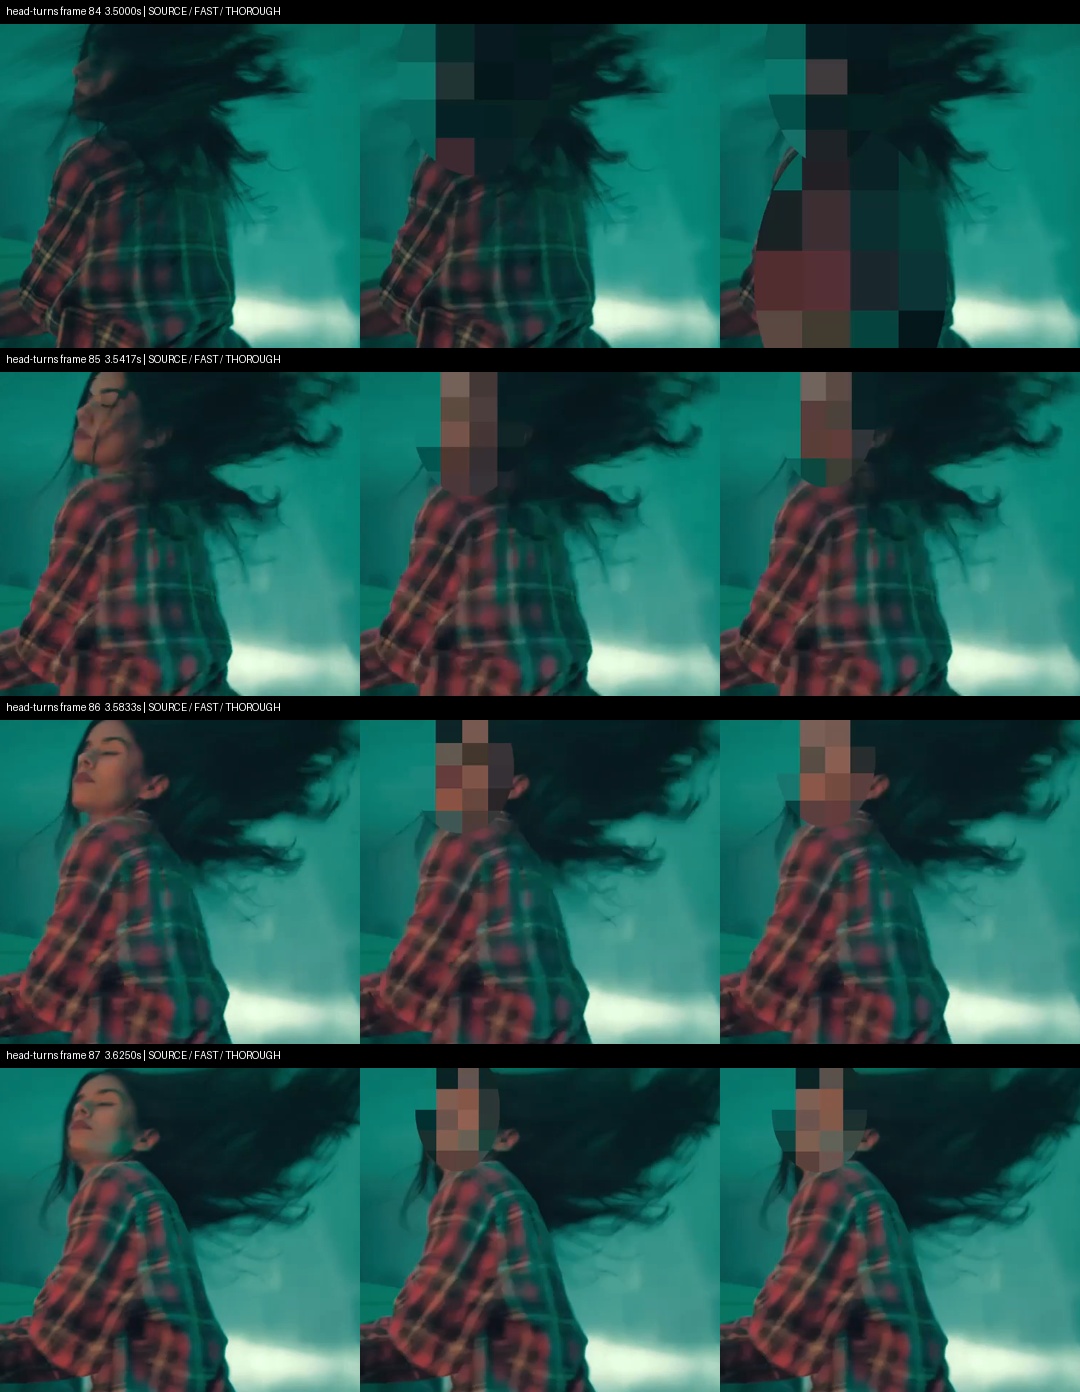
Beide Modi decken jetzt das bei 3,500 Sekunden wieder auftauchende Gesicht im Clip mit Kopfdrehungen ab. Schnell deckt außerdem den zuvor verfehlten ersten Frame der Party-Nahaufnahme ab.
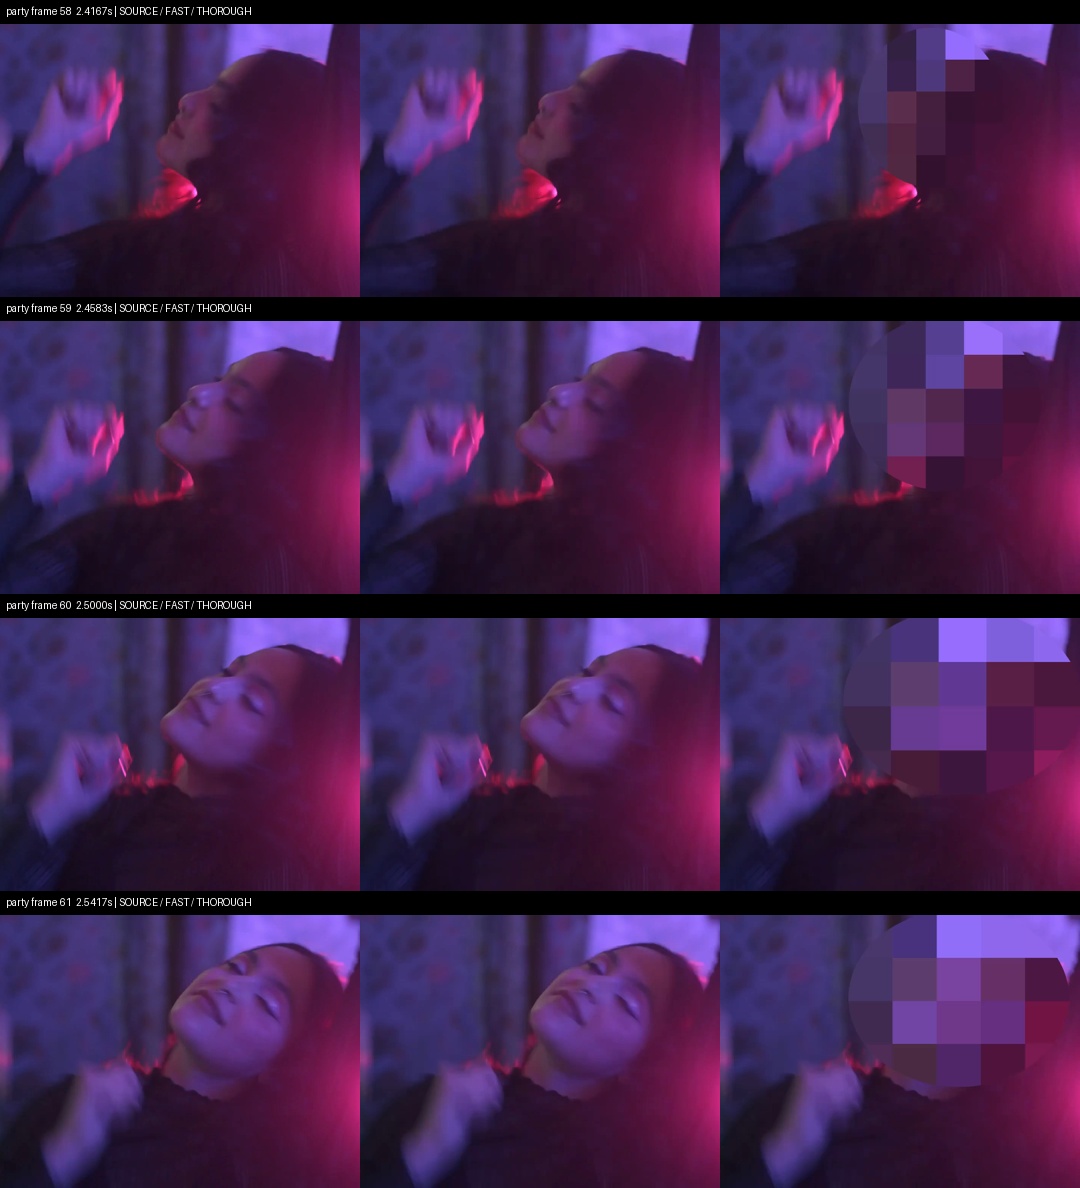
Gründlich deckt die geprüften Fehlerintervalle bei Kopfbewegungen und doppelter Geschwindigkeit ab. Schnell verfehlt im Party-Clip weiterhin sieben aufeinanderfolgende Frames von 2,417 bis 2,708 Sekunden und vier von 2,917 bis 3,083 Sekunden (Endzeitpunkte ausgeschlossen). Bei doppelter Geschwindigkeit bleiben die Masken von Schnell in den Frames 30–31 und 34–36 teilweise oder vollständig aus.
Wir haben dieselben 64 ausgewählten Quellzeitpunkte und 128 Ausgabeframes erneut visuell geprüft. Vorhandene Maskenkoordinaten und Tracking-Kennzeichnungen blieben in allen 3.024 analysierten Frames unverändert; die Korrektur ergänzte nur Masken im jeweils vorherigen Frame. Dies belegt keine vollständige Gesichtsabdeckung in den ungeprüften Frames.
Dieser erneute Test nutzt dasselbe Material, das zur Korrektur führte. Die ausgewählten Frames dienen Regressionstests, nicht einem unabhängigen Genauigkeitsbenchmark. Die früheren 98,3 % sind historisch und bewerten dieses Update nicht.
Fehler beim Wiedererscheinen und Wiederaufnahme ansehen
| Modus | Dekodierte Ausgabeframes | Analysedauer in Sekunden | Exportdauer in Sekunden |
|---|---|---|---|
| Schnell | 1512 / 1512 | 200.9 | 12.8 |
| Gründlich | 1512 / 1512 | 900.5 | 23.4 |
Die Bewegungszeiten stammen aus einem lokalen Lauf mit Belegerzeugung im Hintergrund, nicht aus einem kontrollierten Geschwindigkeitsvergleich. Die Modellinitialisierung ist ausgeschlossen.
Bewegungsvergleich: Quelle links, Schnell in der Mitte, Gründlich rechts. Die Videos zeigen tatsächliche Exporte mit halber Auflösung; Analyse und Export erfolgten mit 1280 × 720 bei 24 fps. Audio wurde entfernt.
Kontrollfall: Laufen von hinten (1×)
Kleine Gesichter und Gruppenchoreografie (1×)
Überlappende Tänzer und Verdeckung durch Hände (1×)
Schnelle Kopfdrehungen und Verdeckung durch Haare (1×)
Schnelle Kopfdrehungen und Verdeckung durch Haare (2×)
Kamerabewegung und Tanzen bei wenig Licht (1×)
Kopfbewegung in Nahaufnahme und farbiges Licht (1×)
Kopfbewegung in Nahaufnahme und farbiges Licht (2×)
Ganzkörpertanz und Haarbewegung (1×)
Über die Kamera laufen und das Bild verlassen (1×)
Bewegungsprotokoll aller Frames herunterladen (CSV) · Bewegungsprüfung und Fehlerintervalle (JSON) · Zusammenfassung der Bewegungstests (JSON) · Herkunftsmanifest der Bewegungstests (JSON)
Historischer Bewegungstest: vor dem Tracking-Update
Frühere Fehler, Exporte und Zeitmessungen prüfen
Stresstest mit durchgehender Bewegung
Neun frisch heruntergeladene Stockvideos, 12 Szenarien, 63 Sekunden und 1.512 aufeinanderfolgende Frames pro Modus. Drei Szenarien laufen zusätzlich mit doppelter Geschwindigkeit. Es wurden keine Nutzer-Uploads verwendet.
Jeder Frame wurde analysiert und jeder exportierte Frame dekodiert. Diese Prüfungen bestätigen die Verarbeitung, keine vollständige Gesichtsabdeckung. Die 98,3 % unten gelten nur für den früheren Test mit festen Stichproben.
Ergebnisse bei Bewegung
Schnell verfehlte beim Kopfrollen in Nahaufnahme acht aufeinanderfolgende Frames mit sichtbarem Gesicht, von 2,417 bis 2,750 Sekunden (Ende exklusiv). Gründlich deckte dieses Intervall ab. Schnell verfehlte außerdem fünf Frames von 2,917 bis 3,125 Sekunden.
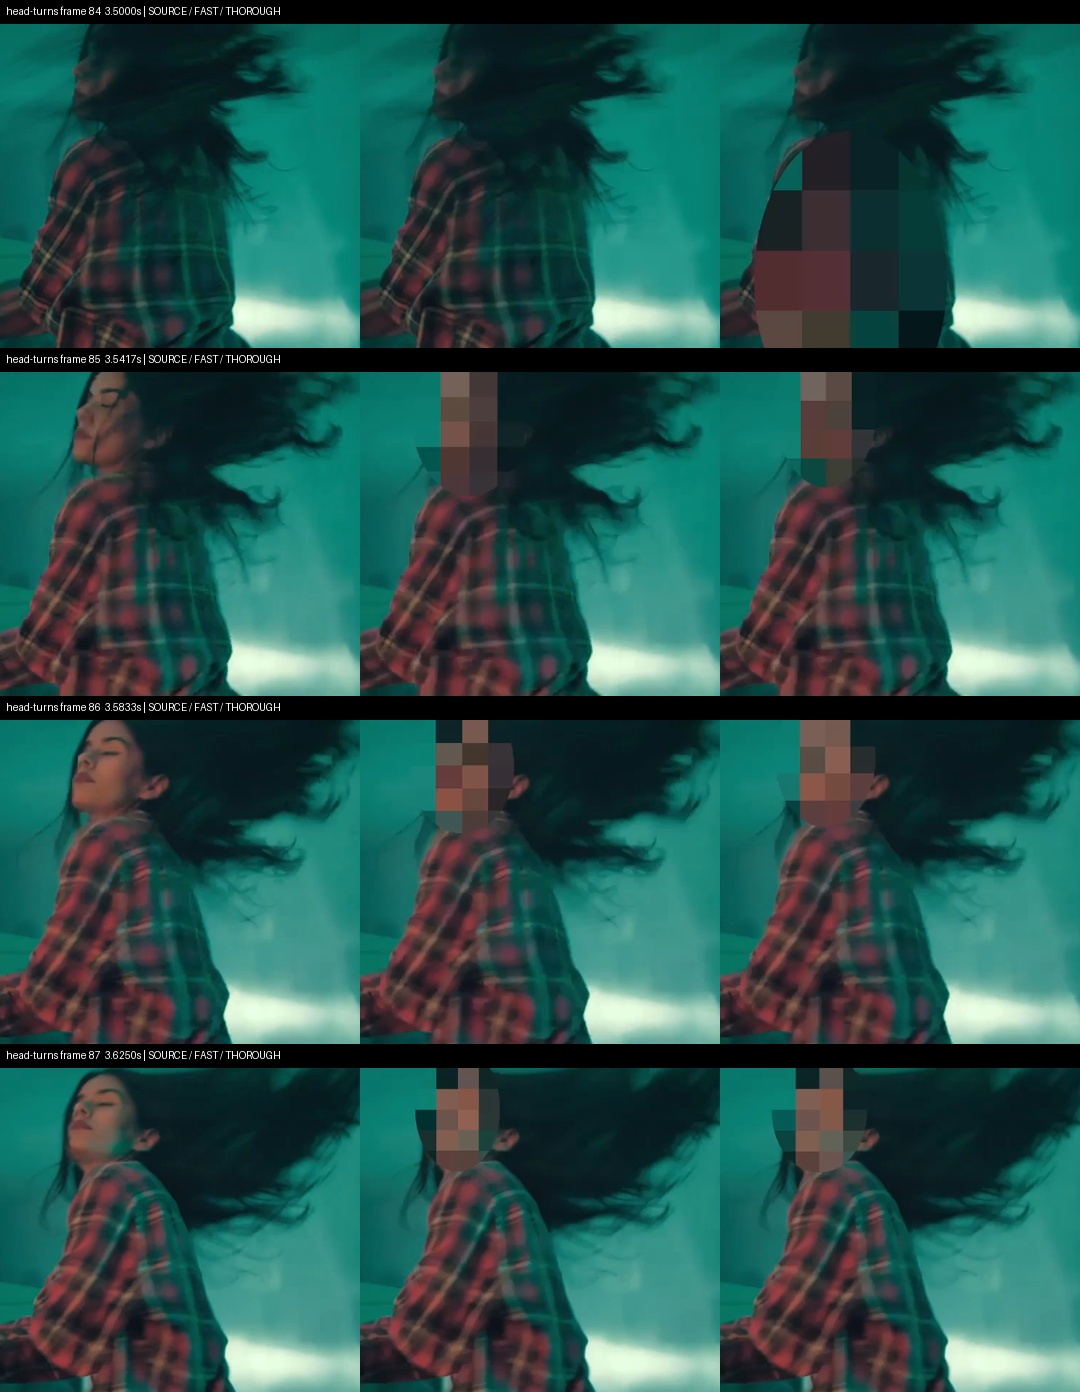
Beide Modi verfehlten das bei 3,500 Sekunden wieder sichtbare Gesicht im Kopfdrehungsclip und deckten es ab 3,542 Sekunden erneut ab. Gründlich setzte im verfehlten Frame eine Maske auf den Oberkörper statt auf das Gesicht.
Bei doppelter Geschwindigkeit erzeugte Schnell auch nachlaufende Masken, die Gesichtszüge sichtbar ließen. Eine Maskenanzahl über null beweist keine Gesichtsabdeckung. Diese ausgewählten Fehler ergeben keine vollständige Rangfolge für alle Bewegungsszenarien.
Codex hat ausgewählte Fehlerintervalle Frame für Frame geprüft. Dies ist weder eine umfassende Genauigkeitsbewertung bei Bewegung noch eine unabhängige menschliche Prüfung. Ein Frame ohne Masken bedeutet nicht automatisch ein übersehenes Gesicht.
Fehlerframes beim Kopfrollen ansehen · Fehler beim Wiedererscheinen und Wiederaufnahme ansehen
| Modus | Dekodierte Ausgabeframes | Analysedauer in Sekunden | Exportdauer in Sekunden |
|---|---|---|---|
| Schnell | 1512 / 1512 | 176.5 | 19.7 |
| Gründlich | 1512 / 1512 | 753.4 | 11.6 |
Die Bewegungszeiten stammen aus einem lokalen Lauf mit Belegerzeugung im Hintergrund, nicht aus einem kontrollierten Geschwindigkeitsvergleich. Die Modellinitialisierung ist ausgeschlossen.
Bewegungsvergleich: Quelle links, Schnell in der Mitte, Gründlich rechts. Die Videos zeigen tatsächliche Exporte mit halber Auflösung; Analyse und Export erfolgten mit 1280 × 720 bei 24 fps. Audio wurde entfernt.
Kontrollfall: Laufen von hinten (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 0–6s → 6s
Kleine Gesichter und Gruppenchoreografie (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 4–10s → 6s
Überlappende Tänzer und Verdeckung durch Hände (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 3–9s → 6s
Drehungen und Radschläge (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 0–6s → 6s
Drehungen und Radschläge (2×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 0–6s → 3s
Schnelle Kopfdrehungen und Verdeckung durch Haare (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 2–8s → 6s
Schnelle Kopfdrehungen und Verdeckung durch Haare (2×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 2–8s → 3s
Kamerabewegung und Tanzen bei wenig Licht (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 1–7s → 6s
Kopfbewegung in Nahaufnahme und farbiges Licht (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 5–11s → 6s
Kopfbewegung in Nahaufnahme und farbiges Licht (2×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 5–11s → 3s
Ganzkörpertanz und Haarbewegung (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 5–11s → 6s
Über die Kamera laufen und das Bild verlassen (1×)
Vergleichsvideo öffnen · Mixkit-Stockquelle · 0–6s → 6s
Bewegungsprotokoll aller Frames herunterladen (CSV) · Bewegungsprüfung und Fehlerintervalle (JSON) · Zusammenfassung der Bewegungstests (JSON) · Herkunftsmanifest der Bewegungstests (JSON)
Bewegungsrohdaten: Schnell · Bewegungsrohdaten: Gründlich
Die Quellen wurden für diesen Test direkt von Mixkit heruntergeladen. Das Manifest enthält Quell-Hashes, Ausschnitte, Wiedergabegeschwindigkeiten sowie Modell-, Code- und Beleg-Hashes. Der Lauf-Kontrollfall zeigt Personen von hinten und zählt nicht als erfolgreiche Gesichtsabdeckung.
Historische Basislinie mit fester Stichprobe: 98,3 %
Dieser frühere Testlauf bewertete 59 sichtbare Gesichtsinstanzen in ausgewählten Stockbildern. Die Abdeckungsquote von 98,3 % gilt für diese Stichprobe und App-Version; sie ist weder ein Genauigkeitswert der aktuellen App noch eine Anzahl unterschiedlicher Personen.
| Modus | Abgedeckt / Gesichter | Abdeckung | Übersehen | Fehlalarme |
|---|---|---|---|---|
| Schnell (YuNet) | 58 / 59 | 98.3% | 1 | 20 |
| Gründlich (SCRFD-10G) | 58 / 59 | 98.3% | 1 | 10 |
Die Abdeckung zählt sichtbar maskierte Gesichter zu festen Zeitpunkten. Fehlalarme sind Masken auf nichtmenschlichen Objekten oder dem Hintergrund. Gezählt werden Gesichtsinstanzen, keine unterschiedlichen Personen.
Beide Modi verpassten das angeschnittene Gesicht bei 10,5 Sekunden im Gruppenclip. Gründlich halbierte die Fehlalarme in dieser Stichprobe, brauchte aber länger für die Analyse.
Ergebnisse nach Szenario
| Szenario | Frames | Gesichter | Schnell: abgedeckt / Fehlalarme | Gründlich: abgedeckt / Fehlalarme |
|---|---|---|---|---|
| Frontale Nahaufnahme | 5 | 5 | 5 / 0 | 5 / 0 |
| Volles Profil | 12 | 12 | 12 / 0 | 12 / 2 |
| Verdeckung durch Hände und Haare | 15 | 15 | 15 / 9 | 15 / 2 |
| Gruppe bei wenig Licht | 15 | 27 | 26 / 11 | 26 / 6 |
Belastungstest mit entfernten Fußgängern
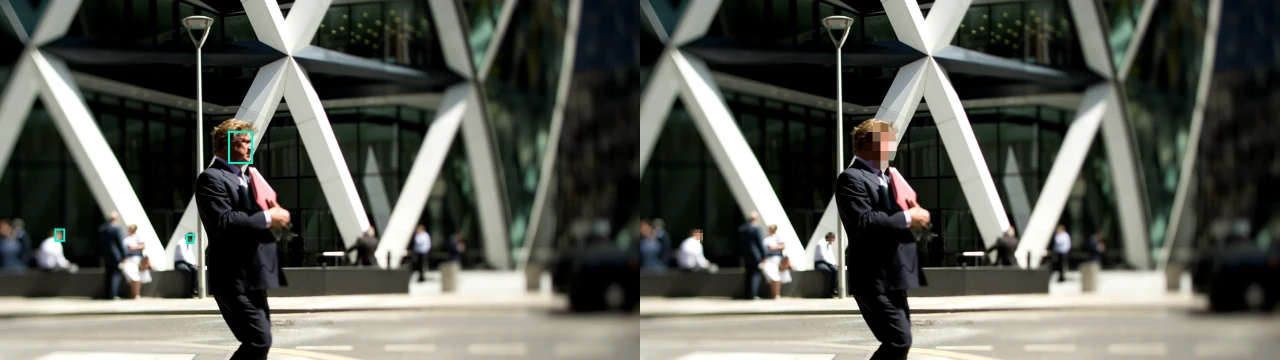
Die 18 Aufnahmen der entfernten Menschenmenge bleiben unbewertet, da Unschärfe und Entfernung die Gesichtszuordnung erschweren. Sie fließen nicht in den Abdeckungsanteil ein.
Masken in den unbewerteten Aufnahmen: 95 Schnell · 76 Gründlich
Bildnachweise der historischen Basislinie
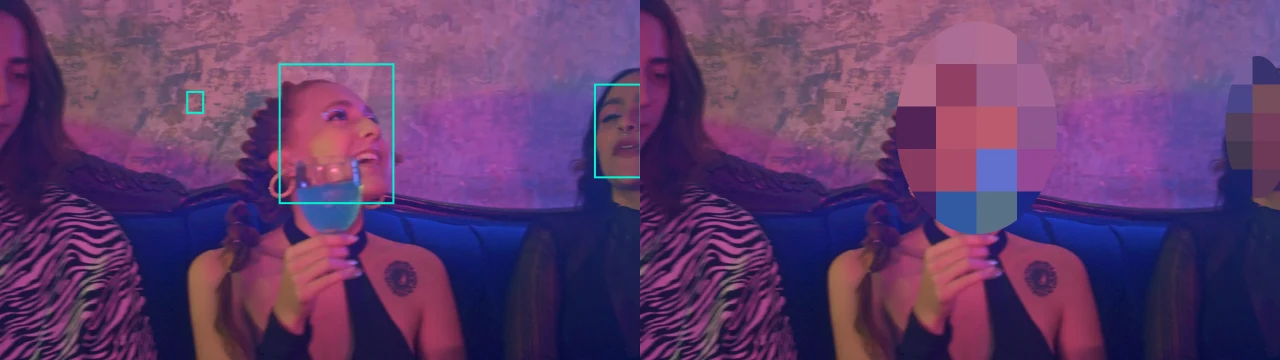
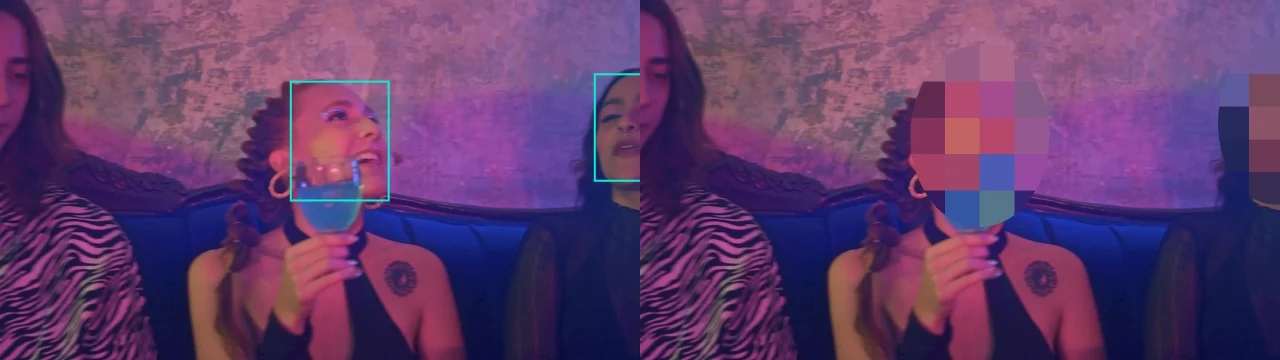
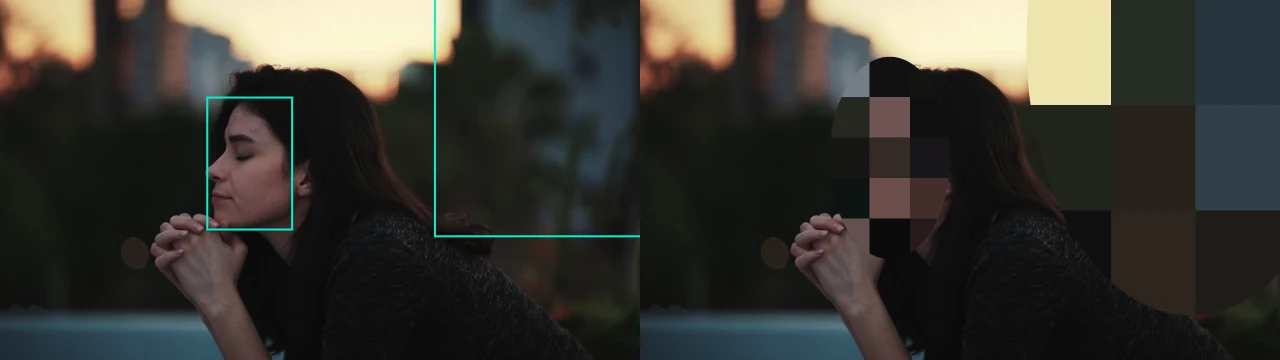
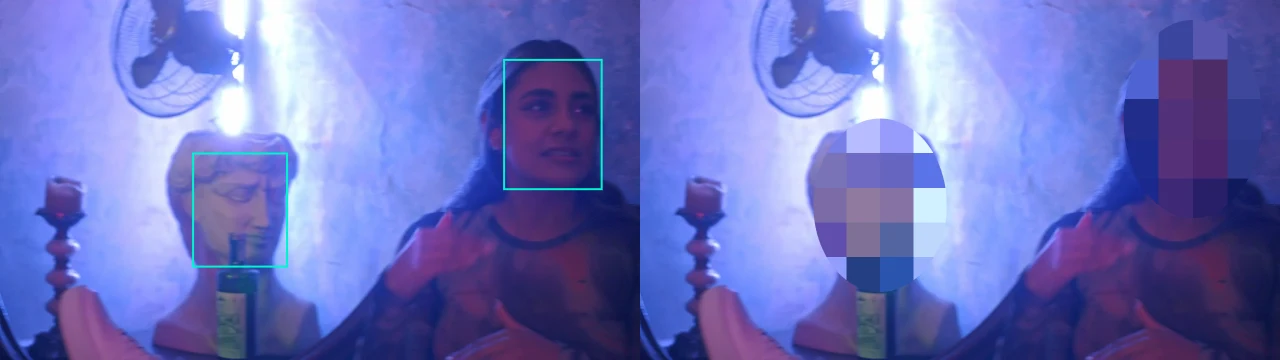
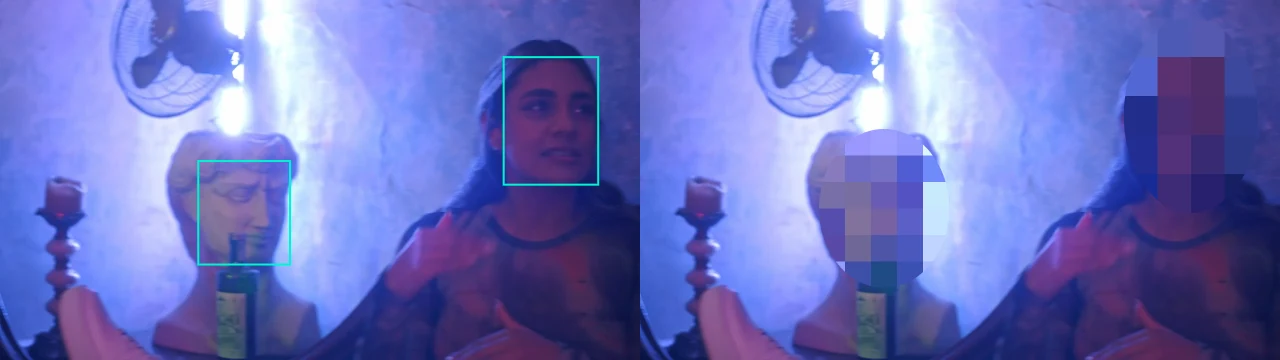
Stockquelle und Erkennungsrahmen links; verpixelte Ausgabe rechts.
Gruppe bei wenig Licht
Sekunden
Verdeckung durch Hände und Haare
Sekunden
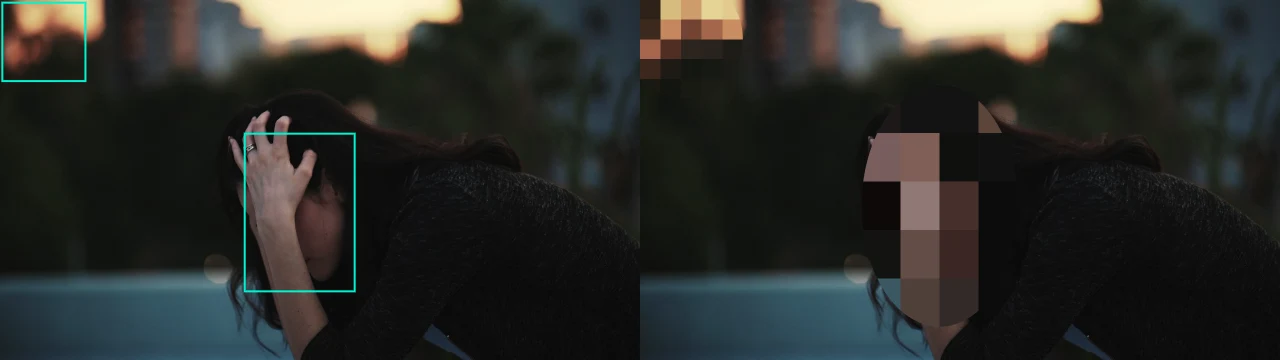
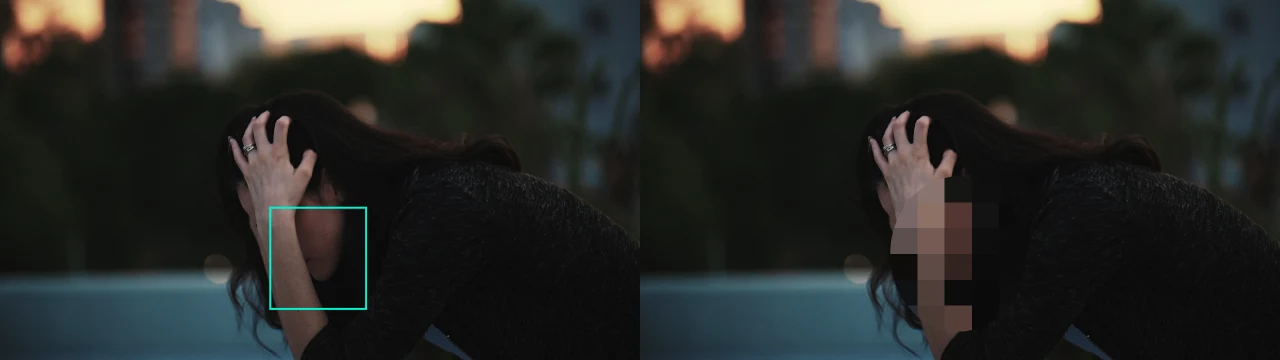
Verdeckung durch Hände und Haare
Sekunden
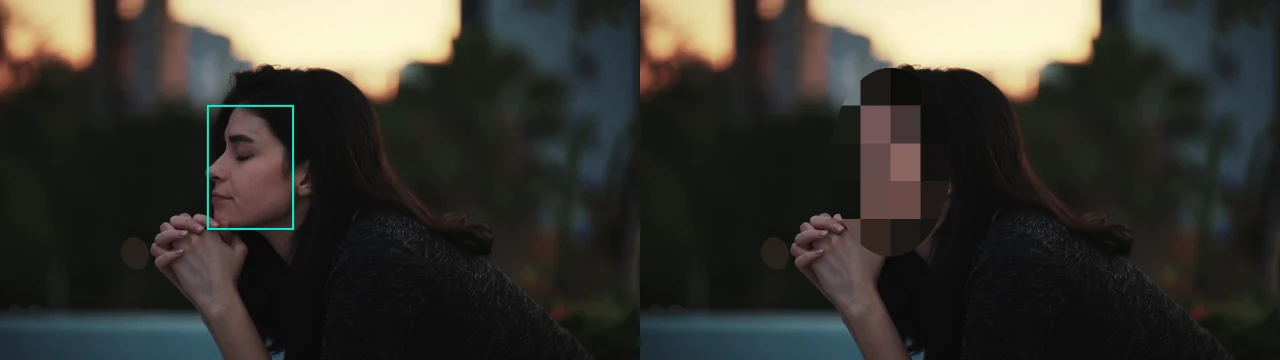
Gruppe bei wenig Licht
Sekunden
Belastungstest mit entfernten Fußgängern
Sekunden
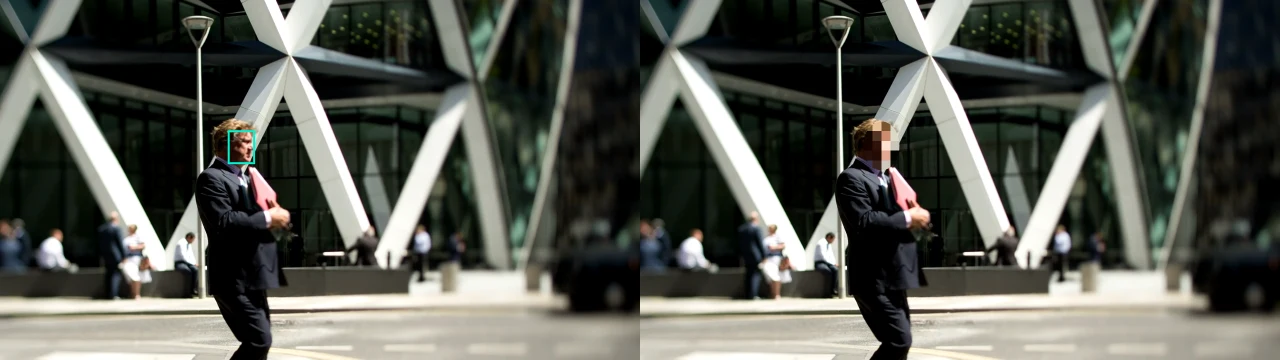
Alle Frame-Ergebnisse herunterladen (CSV) · Visuelle Annotationen (JSON)
Methode und Grenzen der historischen Basislinie
Beide Modi analysieren jeden dekodierten Frame, verfolgen Gesichter und schließen Lücken. Der Export nutzt die gespeicherte Analyse. Einstellungen: Mosaik, Stärke 72, Rand 42, keine manuellen Änderungen, ohne Audio.
Geprüft werden feste Stichproben ab 0,5 Sekunden im Sekundenabstand: 5 frontal, 12 im Profil, 15 mit Verdeckung, 15 Gruppen- und 18 Menschenmengenbilder. Quellauflösung: 1280 × 720.
Eine visuelle Codex-Prüfung bewertet Quell- und Ausgabebilder; eine unabhängige menschliche Prüfung fehlt. Profile, teilweise verdeckte und angeschnittene Gesichter zählen. Statuen sowie reine Haar-, Kinn- oder Nasenspitzenfragmente zählen nicht.
Masken auf ausgeschlossenen menschlichen Fragmenten bleiben unbewertet: keine bei Schnell, zwei bei Gründlich.
Ein abgedecktes Gesicht hat seine sichtbaren Augen, Nase und Mund durch Mosaik verdeckt. Fehlende oder unvollständige Masken zählen als Auslassung. Geprüft wird die sichtbare Maskierung, nicht die Identifizierbarkeit.
Der frühere BlazeFace-Test nutzte andere Videos und Annotationen. Seine Prozentwerte sind mit diesem Lauf nicht direkt vergleichbar.
Exportprüfungen der historischen Basislinie
Alle fünf Clips wurden in beiden Modi exportiert und jeder Ausgabeframe erfolgreich dekodiert. Die Framezahlen stimmten mit der Analyse überein; die Ausgabe hatte 1280 × 720 Pixel und keine Audiospuren.
| Modus | Dekodierte Ausgabeframes | Analysedauer in Sekunden | Exportdauer in Sekunden |
|---|---|---|---|
| Schnell | 1637 / 1637 | 196.4 | 19.3 |
| Gründlich | 1637 / 1637 | 761.7 | 10.5 |
Testumgebung: Chrome 153.0.8010.53 · macOS · ONNX Runtime WASM · 4 Threads
Die Zeiten stammen aus einem lokalen Browserlauf ohne Oberfläche und sind keine Geschwindigkeitsgarantie. Modellinitialisierung ist ausgeschlossen; der Export nutzt die gespeicherte Analyse. Andere Browser und Geräte wurden nicht erneut geprüft.
Maschinenlesbare Zusammenfassung · Rohdaten: Schnell · Rohdaten: Gründlich
Quellen und Herkunft
Für diesen Test wurden neue Kopien direkt von Mixkit geladen. Das Manifest enthält Quellseiten, Download-URLs, Abrufzeiten sowie Hashes der Quelldateien, Modelle, des Codes und aller Belegbilder. Vor dem Öffnen prüft der Test die Freigabeliste.
- Frontale Nahaufnahme · Mixkit
- Volles Profil · Mixkit
- Verdeckung durch Hände und Haare · Mixkit
- Gruppe bei wenig Licht · Mixkit
- Belastungstest mit entfernten Fußgängern · Mixkit
Mixkit-Lizenz für kostenlose Stockvideos · Herkunftsmanifest (JSON)
Videolizenz und Modelllizenz sind getrennt. Gründlich verwendet SCRFD-Gewichte unter den ursprünglichen Bedingungen für nichtkommerzielle Forschung.
Prüfen Sie Ihr eigenes Video
Prüfen Sie automatische Masken und ergänzen Sie fehlende Gesichter manuell.
Tool öffnen